|
核心观点: 高性能、高容量且易获得的盘类存储,为KV Cache摆脱以CPU内存为中心的传统卸载架构提供了介质基础;稀疏化推理则进一步推动KV Cache从全量常驻走向按需流转,形成由XPU索引、XPU热点缓存、高性能外部存储和高效数据通路协同工作的分层体系。 |
1 两股力量推动KV Cache架构演进
随着长文档理解、代码分析、多轮对话和智能体记忆等场景发展,KV Cache随上下文和并发规模持续增长,XPU高带宽存储的容量压力日益突出。
传统KV Cache卸载通常以CPU内存作为外部承载层,规模扩大后仍会受到容量、成本和资源可获得性的约束。根据上一篇文章的观点似乎可以指向一条可行技术路径:通过采用具备内存级访问能力的高性能盘类存储,能够以更大容量承载完整的历史KV数据;随着其I/O性能持续提升、资源供给日益丰富,这将为逐步替代传统内存卸载方案奠定基础。
介质演进回答了“完整历史KV可以放在哪里”,稀疏化推理进一步回答“每一步需要哪些KV,以及如何及时送达计算侧”。传统注意力机制(Attention)需要全量访问历史KV,稀疏化推理只选择其中的关键数据,访问模式由连续扫描转向热点集中的选择性访问。当长上下文与高并发同时出现,系统需要把完整历史与当前工作集分开,让高价值的XPU高带宽存储从历史仓库回归计算工作区。
因此,新的目标不再是让全部KV始终靠近计算,而是让当前真正需要的KV靠近计算。
2 稀疏化推理呈现KV Cache分层趋势
稀疏化推理缩小了单步计算和访问范围,却不会消除完整历史KV的容量需求。系统需要区分两类数据:用于识别、定位关键Token的索引信息,以及实际参与Attention计算的KV数据。前者更加轻量,适合靠近XPU维护;后者体量更大,需要在当前工作集与完整历史之间分层。
分层KV Cache需要明确三个基本边界:一是将完整历史与当前工作集分开,由XPU承接热点KV、由外部存储保存完整历史;二是将数据识别与数据承载分开,由索引结果驱动精准读取;三是让数据流转与计算节奏协同,使缓存命中、缺失补充、状态更新和Attention计算形成连续处理链路。
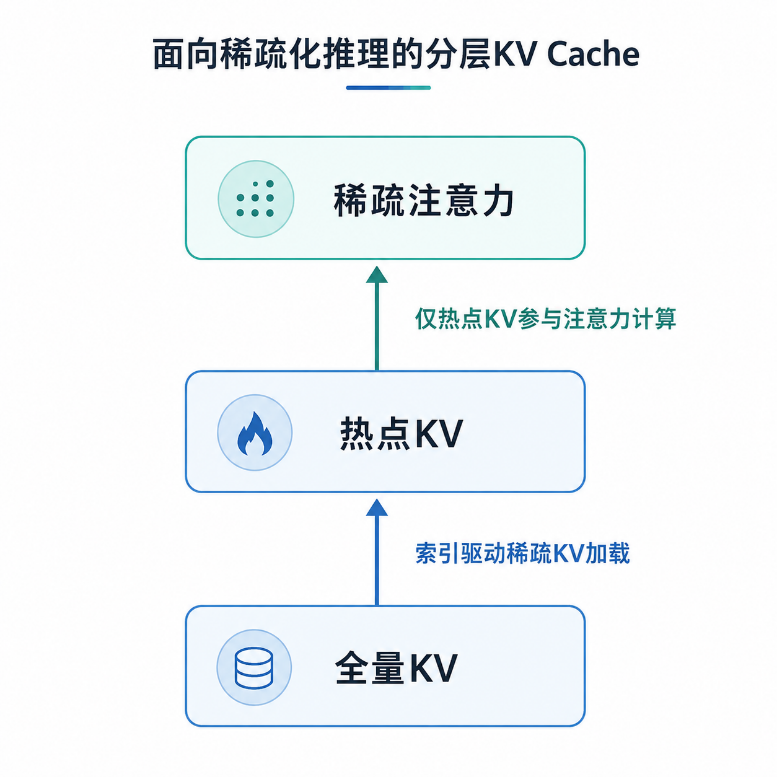
这一架构并不是简单地“把KV搬到外面”,而是围绕稀疏访问重新组织数据:命中数据直接使用,缺失数据按需进入XPU,新增KV持续沉淀到外部存储。它并非仅服务于Decode阶段的稀疏化推理,也同样适用于Prefill阶段。因此它可以同时服务超长上下文、高并发会话以及Prefill与Decode分离等场景。
在Prefill阶段,模型需要一次性计算并生成全量KV Cache,传统做法将其完整驻留在DRAM中,随着上下文规模增长,内存成本和容量压力随之急剧上升。分层架构允许将Prefill产生的完整KV直接写入高性能外部存储,仅保留参与当前计算的工作集在XPU中,从而以更低成本、更高容量的盘类存储替代DRAM承载全量KV。进入Decode阶段后,同一套分层体系自然延续:外部存储作为完整历史的在线承载层,XPU索引识别当前Query关注的关键Token,热点缓存承接按需载入的工作集,稀疏化推理据此管理热点的进入与淘汰。两个阶段共享一致的数据组织、访问语义和生命周期管理,外部存储在Prefill阶段是全量KV的低成本承载介质,在Decode阶段则转变为支撑稀疏访问的按需供给来源,同一架构贯穿请求始终,避免了阶段切换时的数据搬迁和介质重构。
3 DSA卸载四项能力协同落地
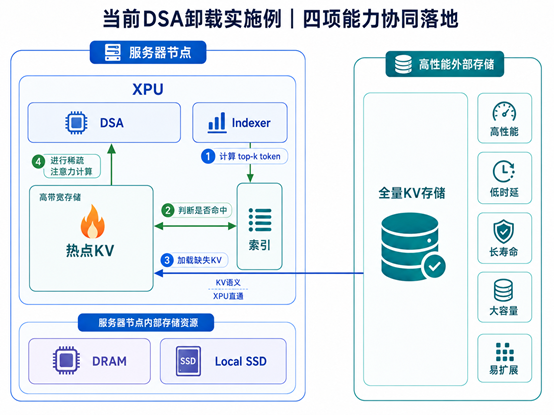
DSA(DeepSeek Sparse Attention)是稀疏化推理的一种具体实践:Indexer先筛选当前Query需要关注的历史Token,再读取对应的Main KV完成稀疏Attention注意力计算。当前卸载实施例围绕这一流程,由以下四项能力协同完成。
3.1 XPU索引:XPU终结查询需求
Indexer完成Token筛选后,相关索引信息与热点驻留状态尽可能靠近XPU维护。XPU索引负责判断当前需要哪些历史Token、哪些已经命中热点缓存、哪些需要从外部存储补充,以及数据就绪后从何处参与计算。
索引承担的是定位与访问决策,而不是Main KV存储。它使系统从“先准备全部历史”转向“先识别需求,再精准准备数据”,并减少每一步Decode在CPU与XPU之间反复传递和解析索引结果,将索引查询时延从毫秒级降低到数十微妙级。
3.2 XPU热点缓存:HBM用在刀刃上
热点缓存以固定或可控容量保留正在使用、近期命中或可能复用的KV,并维护逻辑Token与本地位置的关系。已驻留数据可直接参与计算;发生缺失时,系统准备空间、补充数据并更新本地工作集。
随着请求运行,高频数据留在XPU,低频数据不再长期占用高带宽存储。XPU由此从“完整历史仓库”转变为“计算工作区”,有限容量更多服务于当前计算和热点复用,整体HBM占用降低90%以上,可支撑长序列推理BS(Batch Size)扩大数倍。
3.3 高性能外部存储:强大的KV承载层
外部存储保存完整历史Main KV,并在热点缓存缺失时提供数据。它不能被视为低速归档层:缺失读取会进入Decode关键路径,新Token也会持续产生新的KV状态,因此需要同时满足:
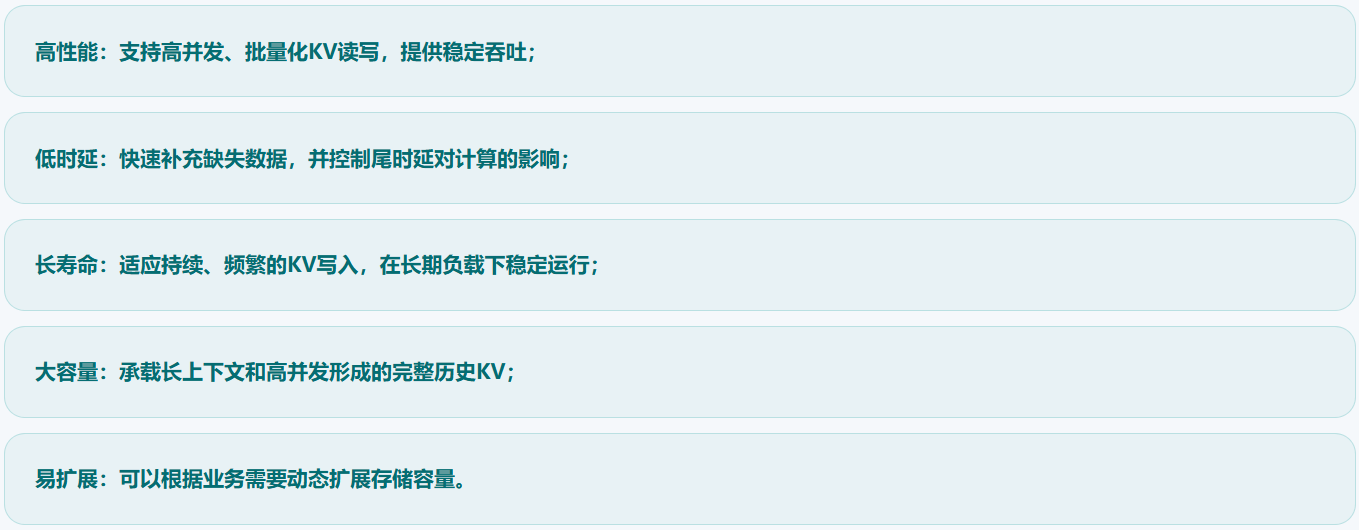
同时,外部存储还需要随请求创建、运行和结束正确管理KV生命周期。只有性能、时延、寿命和容量协同满足,外部存储才能替代传统内存卸载,而不会成为新的I/O瓶颈。
3.4 高效数据通路:支持KV语义与XPU直通
通用I/O只处理块或文件,并不了解请求、序列、层、Token及K/V之间的关系。若每一步Decode都由CPU解析索引、组织零散读取并转发数据,外部存储的性能优势可能被软件调度和多次拷贝抵消。
因此,数据通路首先需要支持KV语义:围绕KV Cache的组织方式表达读写需求,将稀疏索引转换为批量访问,保持K/V数据与逻辑位置的对应关系,并覆盖创建、读取、更新和回收生命周期。
其次需要支持XPU直通:KV载荷在XPU高带宽存储与外部存储之间高效流转,减少CPU中转和重复拷贝。CPU主要负责请求生命周期与资源管理,数据面则尽可能靠近XPU形成闭环。
典型流程可以概括为:
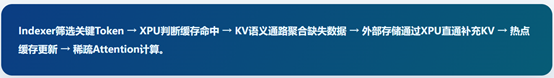
四项能力分别回答“需要谁”“哪些留在XPU”“完整历史存在哪里”和“KV如何流转”,共同构成当前DSA卸载实施例。
收益评估:
高效数据通路与外部存储访问总体时延需要在亚毫秒级,结合缓存BS提升与XPU索引直驱访问,端到端推理吞吐可提升30%-50%。
4 全量常驻走向按需流转
高性能盘类存储解决了完整历史KV的容量承载问题,稀疏化推理则要求数据围绕当前工作集按需流转。前者解决“存得下”,后者要求“流得动”。XPU索引、热点缓存、高性能外部存储以及支持KV语义和XPU直通的数据通路,将这两种需求衔接起来,构成完整体系。
这一架构有望释放容量空间、提升并发能力、提高高带宽存储利用率和改善传输效率。实际收益仍取决于模型结构、热点分布、缓存规模、命中率及外部数据通路性能,需要在目标业务和硬件环境中验证。
从全量常驻走向按需流转,不是把KV简单搬得更远,而是让完整历史有稳定归宿、当前热点始终靠近计算。当稀疏计算真正匹配稀疏存储,每一GB高带宽资源才能真正用在刀刃上。
上一篇文章链接:https://www.oceanclub.org/cn/subject/info/435