随着AI推理的深度演进,模型规模持续扩大、序列长度不断增加,对内存容量的需求正快速攀升。仅是KV Cache的需求,每生成一个词元,模型都要把对应的 Key 和 Value 缓存下来供后续注意力计算取用。它的体量等于模型层数 × 序列长度 × 隐藏维度;总体内存需求与上下文长度、并发数呈线性关系。两者叠加,便是会造成容量需求指数级的膨胀。
于是行业里出现一句极具张力的判断:“闪存要替代内存了。”这句话对,也不对。更加准确的表述应当是:闪存作为 KV Cache 分级体系中的温/冷层,承接 HBM/DRAM 无法经济承载的长尾容量。热 KV 存储 HBM,这是极致带宽和时延构筑的护城河;但长尾容量下沉至 SSD,则是需求、供给、技术三重力量共同决定的必然路径。
本次从AI演进对存储层级的影响入手,以多篇系列化文章来系统分析AI推理时代什么样的存储结构是更合理的存储层级。该系列文章将从需求入手,从技术栈分层分别从算法层面、网络层面、介质应用层面阐述技术可行性,最后以客户侧超节点应用场景案例说明AI存储层级重构后带来的提升。
一、需求维度:容量与成本对内存需求的双重挤压
1. 内存容量需求的指数级扩张
先看几个简单测算,感受一下内存容量膨胀的速度:
|
≈ 4~320 GB 在 1M 上下文长度下的单请求 KV Cache |
< 300 GB 8×H100 节点 640GB HBM 扣掉权重后留给 KV 的空间——该空间最大时连 1 个 1M 请求都无法满足 |
|
≈ 1~32 TB 100 个用户同时发起长上下文请求,相当于一个机柜的 GPU 内存 |
≈ 4~45 PB 10 万用户 、64k 词元 、 15 轮对话的大规模推理场景下的 KV Cache 需求 |
在智能体(Agentic)负载下,单次运行就可能涉及数百万词元上下文,对应 KV Cache 达 TB级。AI推理的快速演进,对内存容量的需求也急剧上升,远远超过现有设备能够提供的HBM存放能力。
尽管模型厂商通过各种精妙的压缩算法同时接受对精度的一定牺牲,极大的抑制了对KV Cache的容量诉求, 但并没有改变随着上下文增加、并发数增加对内存需求的必然趋势。内存成为日益稀缺的资源仍然是一个不得不面对的问题。
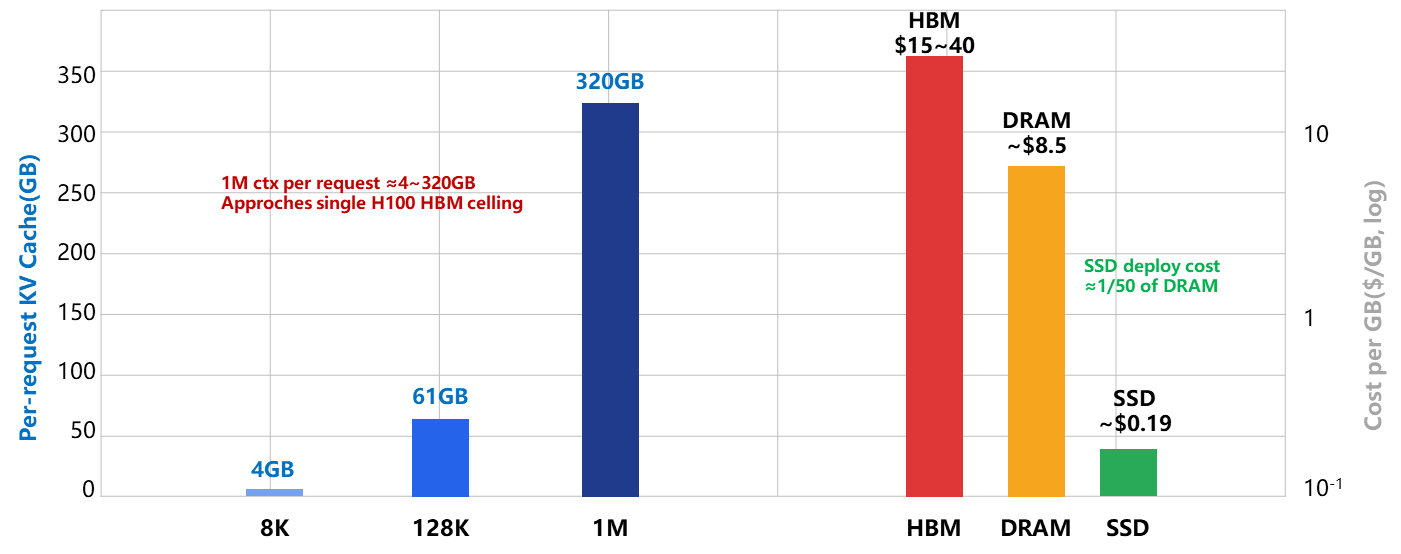
图1:KV Cache 容量随上下文长度指数级膨胀(右轴为 HBM/DRAM/SSD 单位容量成本参考)
2. 内存成本压力的不可持续性
即便按没有明显涨价前HBM 每 GB 15~40 美元计算,仅 32 TB 的内存一项就需要数亿美元。更关键的是,KV Cache 具有强烈的“长尾复用”特征——智能体工作负载中,编码场景 69.2% 的复用块在 10 分钟内被再次访问,但超过 30 分钟的冷复用仍占 10.3%。把所有 KV 都常驻在 HBM/DRAM 上,既不经济,也不可持续。
|
指数级增长的需求,遇到线性扩容的内存,随着存储时间拉长,最终只会导致一个结果:内存容量放不下,成本担不起。 |
二、产业供给维度:DRAM绝对稀缺与NAND相对充裕的剪刀差
1. DRAM/HBM 供给持续紧张,HBM 挤占 DRAM 产能
存储短缺局面的预测持续将至 2028 年,打破了此前“2027 年缓解”的预期。相关研究(2026 年 6 月)给出的供需缺口数据如下:
|
品类 |
2026 缺口 |
2027 缺口 |
2028 缺口 |
|
DRAM |
-5.0% |
-5.9% |
-3.9% |
|
NAND |
-4.4% |
-4.6% |
-3.0% |
|
HBM |
-5.4% |
-6.0% |
-4.3% |
其中HBM 是最紧缺的环节:预计 HBM 供需缺口将持续到 2028 年,受 ASIC 需求加速驱动,HBM容量需求未来三年CAGR达 85%,而DRAM 晶圆产能继续向 HBM 倾斜,HBM 晶圆占比预计从 2026 年的 24% 升至 2028 年的 31%。同时HBM 生产所需晶圆产能是普通 DRAM 的 3–4 倍;三大原厂每月约 139 万–154 万片可用洁净室产能中,约 30% 将被强制锁定用于 HBM 生产,进而挤压普通 DRAM 供给,并强化 HBM 的紧缺格局。
同时DRAM 技术经长期演进已相对成熟,重大突破有限,容量密度随制程演进仅呈小幅线性增长。高毛利HBM的产能挤占,叠加内存容量密度提升缓慢,使得内存总容量供给长期难以满足业界对容量指数级增长的需求。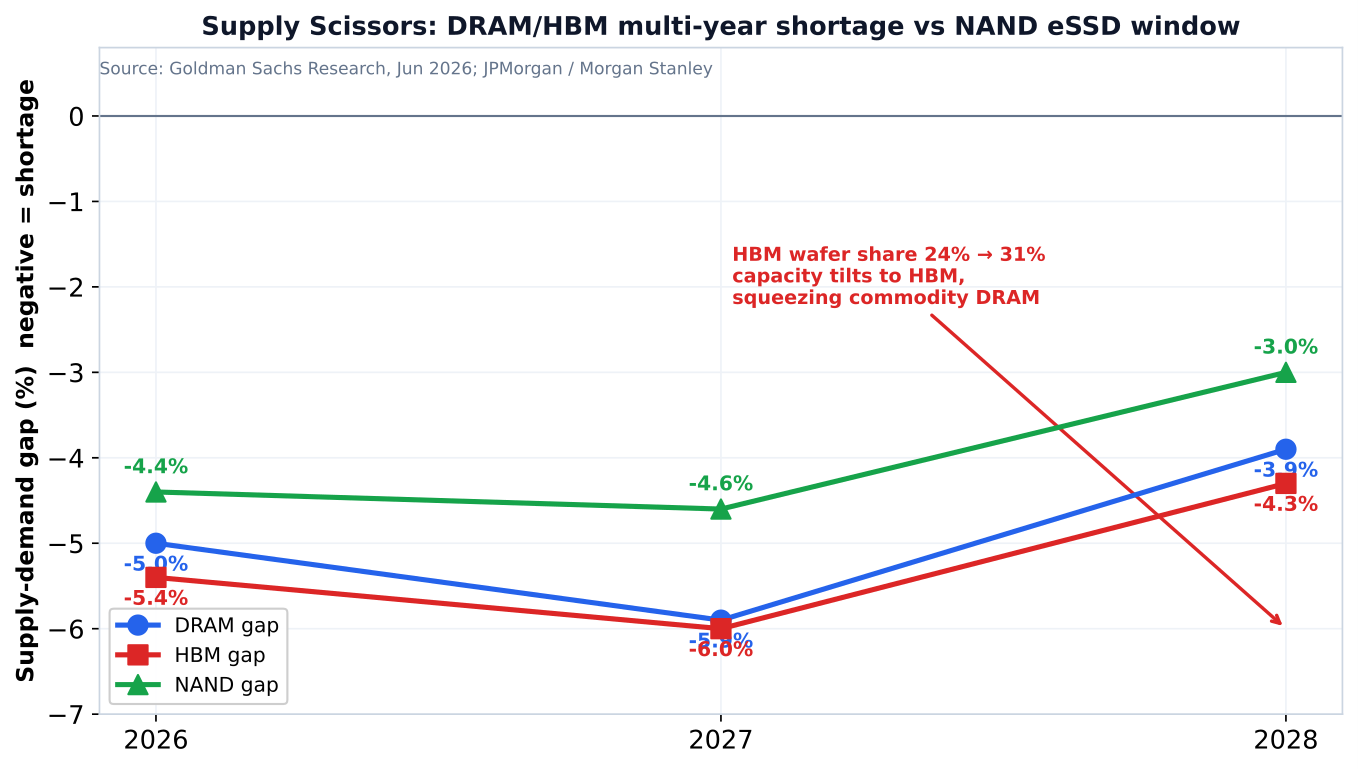
图2:2026–2028 年 DRAM/HBM 供需缺口
2. NAND的相对供应充足
在2026年存储介质需求突飞猛进时,NAND介质同样出现了供应短缺和价格快速上涨,那是否闪存介质是否同样难以填补这一容量缺口呢?对此,有两个基本判断。
1)当前NAND的产能短缺,更多是市场调节的结果,而不是总体产能不足,全球产能尚未达到历史最高供给,且尚未计入部分扩产和产业升级带来的潜在增量。根据TrendForce数据,全球DRAM实际产能预计从2025年底196.6万片/月增至2026年底213.6万片/月,全球NAND Flash实际产能预计从2025年的136.5万片/月降至133万片/月。从整体供给能力看,NAND在并非触及行业产能峰值;在市场供给与调节下,具有更大的供给弹性和产业潜能。
2)NAND技术还处于快速演进阶段,铠侠/闪迪基于332层堆叠,推出了业界最高位元密度37Gb/mm2介质;海力士发布了V10 375层业界首次采用钼金属栅极的NAND介质;面向1000层的NAND技术突破给出了到2030的未来路线,也已被各大原厂陆续披露。从技术演进角度看,NAND介质仍处于技术活跃期,具有容量快速增加的技术前景。
|
NAND与DRAM的供给剪刀差: DRAM 紧缺预计以“年”为单位持续,NAND 企业 SSD 则为买方提供了季度级的窗口期,二者供需态势的差异形成剪刀差,且短期难以弥合。KV Cache 作为 AI 推理最大的单一内存消耗项,对读取速度的要求远低于模型权重的解码路径。而DRAM 的速度优势在时延容忍的可掩盖场景下将大幅收窄, NAND 的容量与成本优势则相应突显。由此,将内存需求下沉至 SSD,成为一条可在产业层面上规模化实现的路径。 |
三、技术可行性维度:工程可行性已被初步验证
1. 分级存储范式的业界共识
参考业界的存储层级划分,行业已构建清晰的四级存储分层架构。
|
层级 |
角色 |
规格 |
|
L1 · GPU HBM |
纳秒级 、活跃 KV |
80–192 GB ~3 TB/s、 活跃解码层 |
|
L2 · 系统 DRAM |
100 纳秒级、暂存/溢出 KV |
数百GB~数TB ~350 GB/s 、 热数据低延迟服务层 |
|
L3 · 本地 SSD / 机架级存储 |
微秒级 、温 KV 复用 |
数TB ~14 GB/s 80–150 μs 、 延长 KV 生命周期 |
|
L4 · 共享对象 / 文件存储 |
毫秒级 、冷 KV / 共享上下文 |
跨节点共享 、成本最优的冷层 |
英伟达Vera Rubin 平台从机架级架构上定义了存储分级的行业参考架构,也获得了主流存储厂商的广泛支持:每 GPU 分配约 16 TB TLC NAND 专用于 CMX(Context Memory Extension)操作,单 NVL72 机柜约 1152 TB SSD 容量;CMX 相关 NAND 消耗将从占全球 NAND 产量 2.8% 升至 9.3%。在 CES 2026上,英伟达表示这是“完全未被服务的市场”,闪存对内存长尾的替代是行业的必然,将成为“全球最大的存储市场”。
2. 闪存技术演进与突破
用于内存替代的SSD 也不再是传统意义的 SSD。AI 工作负载正促使 SSD 厂商设计 GPU/NPU-native 的驱动器,其访问模式发生根本变化:高 IOPS、低延迟、由GPU/NPU 发起读取,而非传统的 CPU 附加存储架构。可以将这种新型的SSD视为一种新兴的闪存为AI存储单元(AI Storage Unit),简称为ASU。
一份基于生产场景验证的定量分析显示:当 KV Cache 预算配置为 512 GB DRAM + 2 TB SSD 的两级缓存配置时,总命中率 88.5%,其中约 95.1% 的命中可由 DRAM 直接服务,仅约 4.9% 需要回退到 SSD 层。这意味着尽管SSD 层访问较慢,但分层分级的访问路径可以让访问压力处于SSD可承载的范围内,从而使SSD成为极具成本效益的扩容方案。
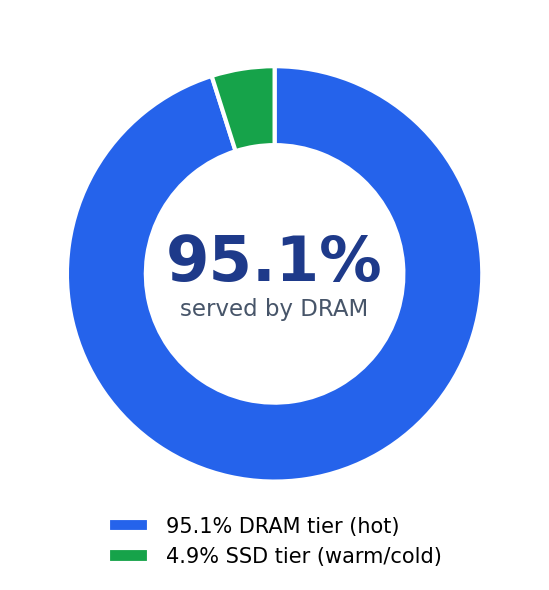
图3:读路径压力分布
开源方面Mooncake 已在生产场景上验证了 SSD 卸载的可行性:将各服务节点的本地 SSD 组织为分布式 KV Cache 池,DRAM 仍作为热数据的低延迟服务层,而容量更大、成本更低的 SSD 层则延长了 KV Cache 的生命周期。学术界研究同步验证:KVDrive 系统跨 GPU 内存、主机 DRAM与SSD 三层之间协同调度,相比 SOTA 方案,吞吐量最高提升 1.74 倍,同时可保持精度;AdaptCache 在同样采用 DRAM+SSD 分层的情况下,相比静态压缩基线,实现 1.43–2.4 倍延迟优化。
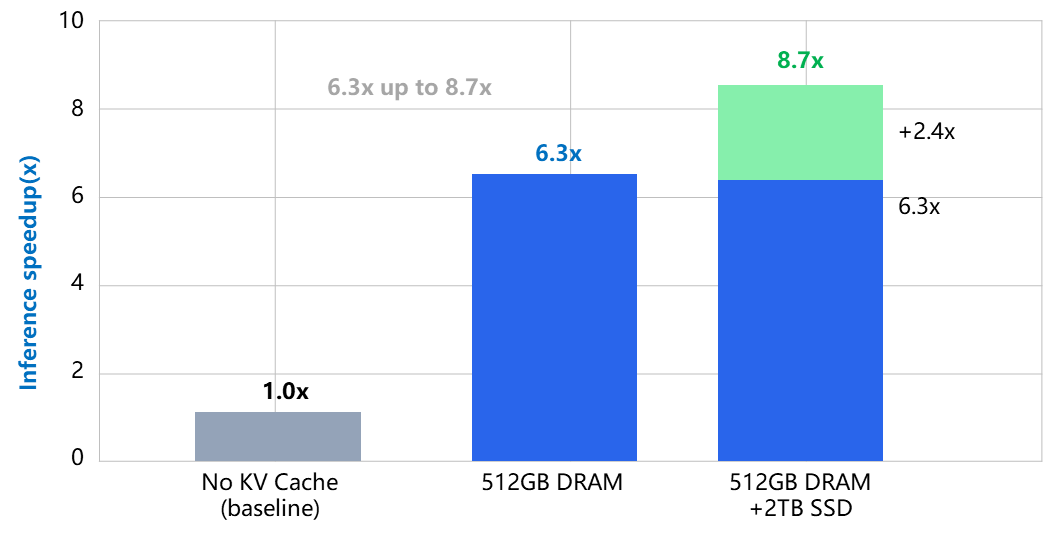
图4:KV Cache 预算加速比
四、从内存到闪存是AI存储层级重构的必然
需求和供给让闪存对内存的补位成为必然的选择,而闪存技术的进步,让AI存储层级的重构具备了工程可行性。
需求侧:
长上下文与智能体负载使 KV Cache 容量远超 HBM/DRAM在经济上可承载的范围。单请求1M 上下文需约 百GB、100 用户并发即达几十TB;大规模推理场景 下,KV Cache 需求高达PB级;Agentic 负载下,单次运行可能涉及数百万词元上下文,对应 KV Cache到TB级别。HBM 和 DRAM 的扩容速度是线性的,但内存需求增长是指数级的。指数级需求对上线性扩容,结果只有一个:必然需要更大容量、更低成本的介质补位。
供给侧:
2026–2028 年 DRAM 供需缺口依次为 −5.0%、−5.9%、−3.9%,HBM 缺口依次为 −5.4%、−6.0%、−4.3%,短缺至少持续至 2028 年。DRAM 晶圆产能继续向 HBM 倾斜,HBM 晶圆占比预计从 2026 年 24% 升至 2028 年 31%。DRAM 紧缺以“年”为单位持续,而NAND 企业 SSD 拥有更强供应能力,二者之间的供需剪刀差短期内难以逆转。
技术侧:
分级缓存架构已被生产场景验证。命中请求时,95.1% 由 DRAM 服务、仅 4.9% 落回退到SSD层——这证明 SSD 层虽然访问速度较慢,但其承担的读路径压力较小。随着SSD技术指标的持续提升,其已成为极具成本效益的 KV Cache 扩容方案。
|
结论:从内存到闪存是AI存储层级重构的必然 当需求侧的指数膨胀、供给侧的多年期紧缺、技术侧的持续突破三股力量指向同一方向时,“SSD 承接 KV Cache长尾”就不再是技术备选,而是长上下文与智能体负载下共同决定的必然路径。 |